 MINYAKO
POAQL:局部视野下获取更优合作
对POAQL这篇文章的阅读以及心得
标签关键词:强化学习 rl 论文阅读 paper-reading Paper Reading
多智能体路径规划问题(Multi-Agent Path Finding,MAPF),一直是多智能体协作中的一个重要问题,MARL一直是解决部分可观测MAPF的一种重要方式。但是,合作式MARL的目标往往是最大化团队收益,但是部分可观测条件下,无法观测的智能体行为会带来不可预测的因素,为此,作者提出了部分可观测的利他 Q 学习方法(POAQL),考虑可观测子团队而非整个团队的累计奖励。这是我们今天这篇论文的核心创新点,也是我们讲解的技术主线。
研究背景
为什么单纯的团队奖励不大行
MAPF,作为一个具体的问题,在电子游戏、自动化仓库、机器人等等领域广泛存在。其目的是最小化所有智能体到达各自目标所需的时间步数总和。在这类问题中,许多合作式的MARL的研究采取的奖励是一个单一信号,即团队奖励,所有智能体共同追求团队奖励的最大化。另一方面,每个智能体自己的奖励信号味个体奖励,一般来说,团队奖励是所有个体奖励之和。但是问题随之出现:
- 怠惰智能体效应:个别智能体表现较差会拖垮整个团队
- 奖励与观测不一致: 智能体的观测只包含了可见智能体,收到的奖励却要求是全部智能体,这种情况下团队奖励是难以预测的,随着不可见智能体增多,这个问题甚至还会更突出
POAQL的思路与假设
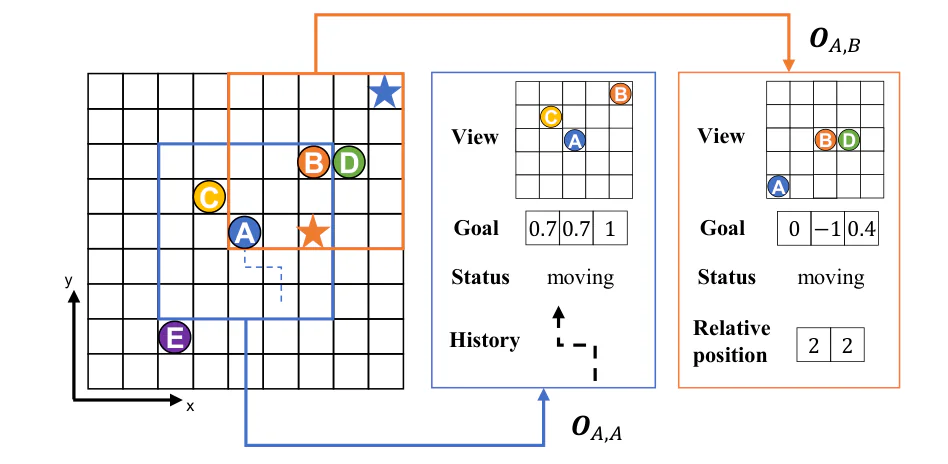
针对上述问题,当时已有的研究给出的是通过信用分配的方式进行,虽然有所改善,但随着智能体数量的上升,联合动作的价值学习依旧变得困难。因此作者提出了POAQL,使得每个智能体最大化的不再是团队奖励,而是一个自身及邻居组成的子团队的累积奖励。
作者看来,因为智能体可以观测到附近的成员,预测这部分奖励应该是相对简单的,并且在本文的环境中,作者进一步提出了一个观点:不可见智能体的奖励和状态转移和当前的子团队是相对隔离的,即使不考虑团队外的智能体,依然能够达成较好的合作。
核心方法
用“利己价值+利他价值”评价动作
POAQL 将动作价值拆成两部分:自己的动作对自身回报的影响,以及对可见邻居回报的影响。顺带一提,以下内容可能涉及一些有关RL的基础公式,如果你尚且不熟悉RL的话,可以等待后续的RL十日谈,我们基本上会涉及这些内容,并且下面的公式我也会有解释,希望你能理解。
首先,定义智能体的累计回报:
其中,奖励项表示智能体 j 在第 t 步获得的个体奖励,折扣因子 γ 用于控制未来奖励的权重。
对采取动作的智能体 i,利己动作价值定义为:
这里,观测项表示关于自身的信息,动作项表示自己的动作,π 表示所有智能体的联合策略。这个式子表达的是在当前信息下,我采取这个动作,预计能给自己带来多少累计回报。
相应地,利他动作价值定义为:
这里的观测项是智能体 i 获得的关于邻居 j 的信息。要特别注意:采取动作的虽然是自己 i,但评价的是邻居 j 的回报。例如,自己暂时让开通道,虽然可能耽误自己的任务,却能帮助邻居更快通过。
设当前可观测子团队为以下集合,包含自己和可见邻居:
用于决策的价值就是自身价值与各个邻居价值之和:
智能体据此选择动作。这样,邻居数量变化时,只需要增减对应的利他项。
邻居离开视野后,如何继续学习?
Q 学习的基本思路是:用“已经获得的奖励+对未来回报的估计”更新当前价值。POAQL 使用 T 步更新:先累计 T 步实际奖励,再估计剩余回报。
但子团队成员会变化,因此不能直接把每一步可见成员的奖励相加,否则更新过程中评价的对象就变了。在这种情况下,POAQL 会始终跟踪原来那个成员 j(这也是我觉得整篇文章可解释性最弱的一部分),其利他价值更新目标为:
前半部分是成员 j 在这 T 步实际获得的奖励;后半部分是从第 T 步开始的剩余回报估计:
- 如果 j 仍然可见,继续使用i 对 j 的利他价值。
- 如果 j 离开视野,改用j 对自己的利己价值。
这里的思路可能不好理解,作者的思路大概是这样的:首先,离开视野之后肯定还要有后续回报,不然含义就会改变,但是已经无法从自己的视角得出利他回报了,怎么办?就只能回归原始方法,用其利己价值作为奖励的估计源来更新自己的价值。
只考虑邻居,为什么可能实现全局合作?
作者依赖下面的近似条件,也是我们前文提及的假设之一:对于不可见的智能体 j,
左右两边只差了“自己的动作”这个条件。它表示:在给定当前观测后,自己选择不同动作,对远处智能体的累计回报影响很小。
因此,远处成员的价值近似是一个不随自己动作变化的项。选择动作时忽略这部分,通常不会明显改变动作的优劣排序,同时还能减少难以预测的回报带来的干扰。
不过,这只是近似假设,不能说严格成立。比较典型的就是若地图存在狭窄通道或长距离拥堵,当前动作也可能影响尚未进入视野的成员,此时忽略远处影响就可能产生偏差。
解决冲突
事实上这也是这篇论文的创新点之一,但相对没这么重要前文就没有提及。
即使每个智能体都考虑了邻居,也可能同时选择进入同一个位置。因此,论文还加入了动作协调机制:
- 所有智能体先分别选择动作。
- 随机选出一对发生冲突的智能体,向其中有替代动作的一方发送禁令。
- 收到禁令的一方重新选择动作,禁令在本轮协调中持续累积。
- 重复检查与调整,直到动作可以安全执行。
至此,利他价值评价和冲突解决机制两者共同构成了论文中的 MAPF 求解方法。
实验部分
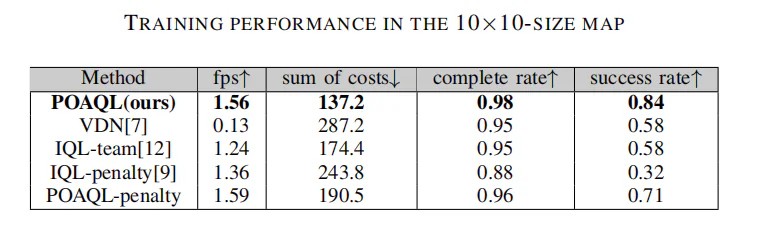
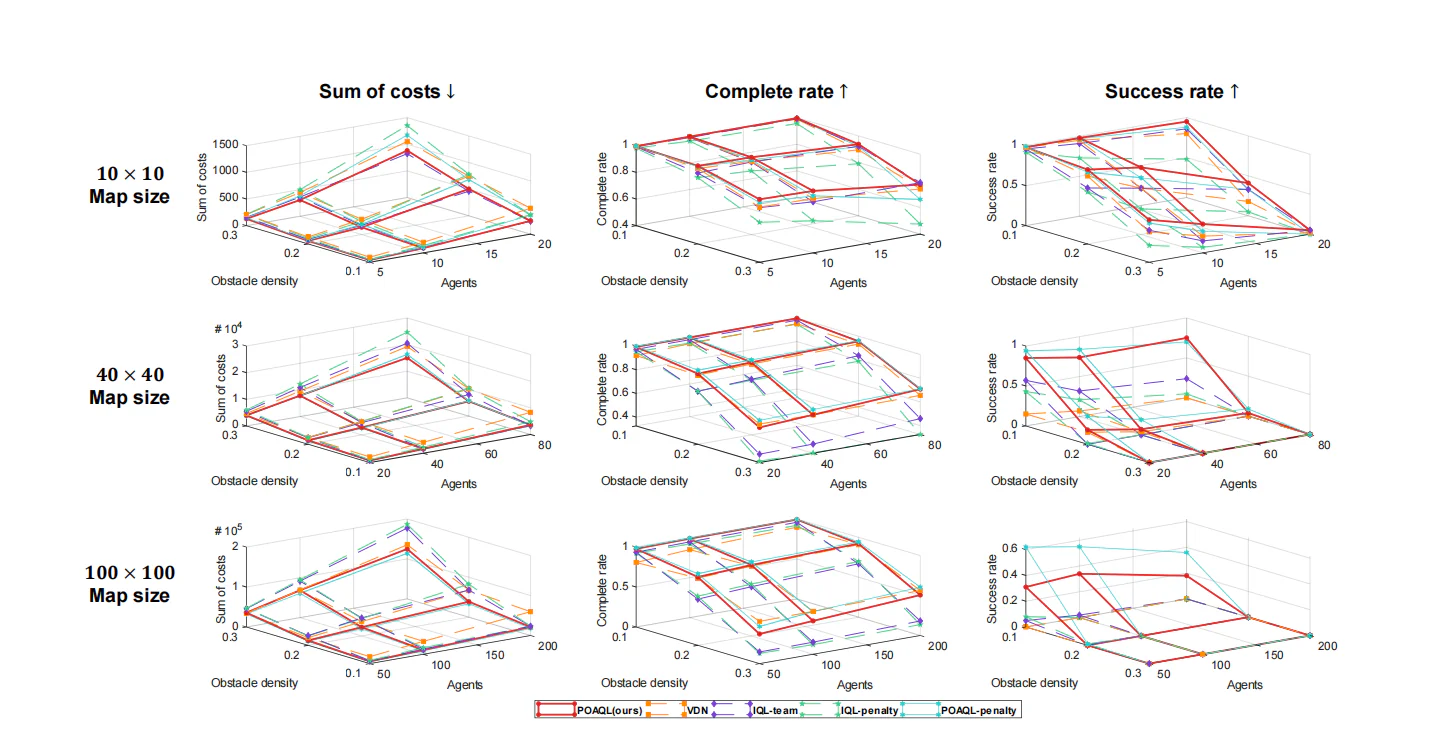
事实上,这篇文章不涉及复杂的实验设计,就只是简简单单的做了方案的对比,我们这里直接贴实验结果吧。
| 方法 | 学习信号或主要设计 | 用来考察什么 |
|---|---|---|
| IQL-team | 各智能体独立学习团队奖励 | 直接学习全队回报的表现 |
| IQL-penalty | 个体奖励+冲突惩罚,冲突时双方停下 | 用额外惩罚促进合作的表现 |
| VDN | 将联合动作价值加性分解 | 信用分配方法的表现 |
| POAQL | 自利+利他价值,以及新的冲突处理 | 完整方法 |
| POAQL-penalty | POAQL搭配惩罚式冲突处理,用来消融上述提及到的新冲突算法 | 检查冲突处理设计的作用 |
以及涉及的三个指标
| 指标 | 含义 | 趋势 |
|---|---|---|
| Sum of costs | 各任务所需时间步数之和 | 越低越好 |
| Complete rate | 已完成任务数/总任务数 | 越高越好 |
| Success rate | 所有任务均完成的案例比例 | 越高越好 |
值得注意的是,这里作者没有选用PRIMAL以及DHC来进行比较,而是用的借鉴了PRIMAL的penalty算法的IQL,至于DHC……我也不知道为什么不用这个做基线,可能是没办法体现他这个方法的显著性吧,要不是我没空我多少要去试试看对比一下
至少我们可以很显然的看出来,POAQL确实在大部分环境下达到了领先,而其penalty版本则是在大地图上相对优势,可能是因为这种惩罚会让其保持安全距离,在近距离下会导致难以发挥,而在空间充裕时表现更佳。VDN在最复杂的任务(100x100,0.3的障碍率)中略优,作者对此的解释是可能是因为多个利他价值叠加产生了误差。
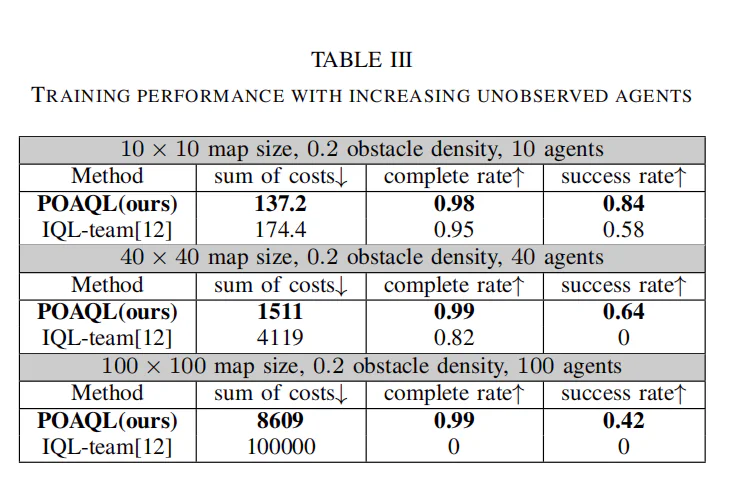
而最后一张表则最显著,在固定视野大小与障碍密度,同时增加地图大小与智能体数量,POAQL的任务完成率一直很高,并没有像IQL一样明显退化。但是全员完成率依旧下降,说明少数的残留失败并没有得到可靠的解决。
结尾
这篇论文的内容基本就是这些了。第一眼看过去会觉得这篇论文的方法很新很好,但其实实际落实到方法上其实好像也就这样。引用量也不高,也算是小众宝藏论文了,但是方法上还是可以借鉴一下的。总之希望我对这篇论文的详解能对你有所帮助。
预览环境已禁用评论;正式发布后恢复。